Es gibt inzwischen Dutzende KI-Modelle, die jeder herunterladen und selbst betreiben kann. Die häufigste Frage dazu lautet: Welches ist das beste? Darauf gibt es keine Antwort, weil es das beste Modell nicht gibt.
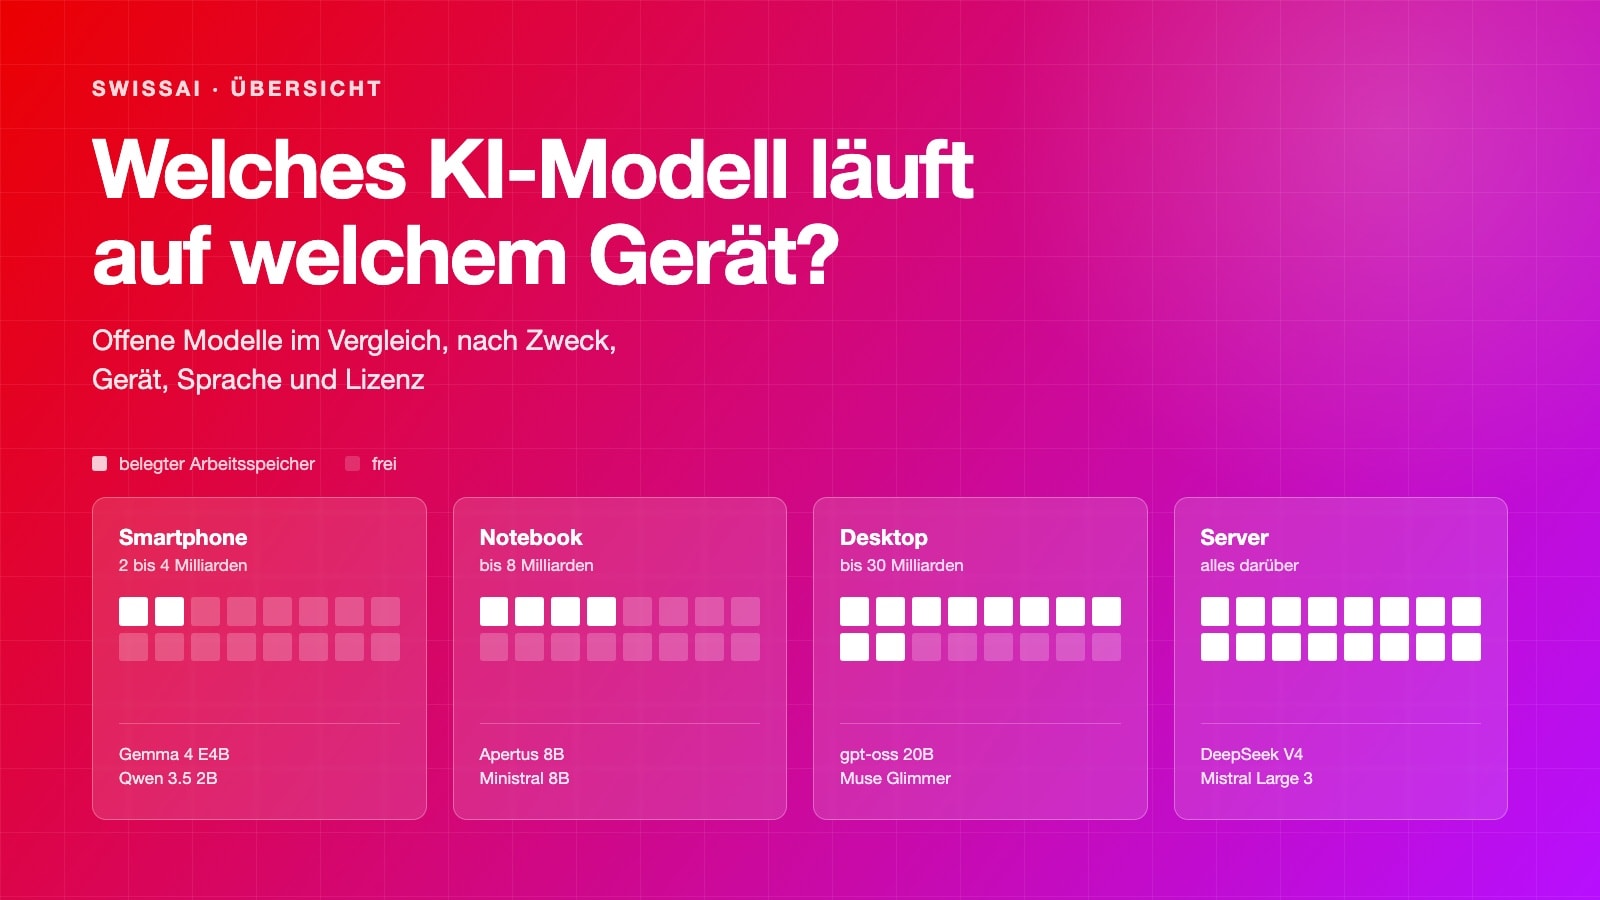
Wir haben deshalb eine Übersicht gebaut, die zwei nützlichere Fragen stellt: Was willst du tun, und was für ein Gerät hast du? Daraus folgt die Empfehlung. Dazu ein Rechner, der zeigt, ob ein Modell in deinen Speicher passt: KI-Modelle im Vergleich.
Drei Dinge aus der Recherche haben uns überrascht.
Erstens: Grösse entscheidet weniger als erwartet
Die deutsche Bundesdruckerei hat zusammen mit dem Fraunhofer-Institut AISEC 39 Modelle an deutschsprachigen Aufgaben geprüft. Das ist derzeit die belastbarste öffentliche Quelle für Deutsch, mit einer Einschränkung: Geprüft wird deutsche Verwaltungssprache, nicht Schweizer Hochdeutsch. Einen vergleichbaren Schweizer Test gibt es bisher nicht.
Beim Beantworten deutscher Fragen steht Qwen3 mit 4 Milliarden Parametern auf Rang 8, direkt hinter GPT-4o auf Rang 6. Ein Modell, das auf jedem Notebook läuft, liegt gleichauf mit einem aus dem Rechenzentrum.
Zwischen den Grössenklassen bleibt ein Abstand, aber er ist kleiner als der Abstand zwischen guten und schlechten Modellen derselben Grösse. Sorgfältig auswählen bringt also mehr als aufrüsten.
Zweitens: Europäische Herkunft ist keine Garantie
Das eigens für die EU-Amtssprachen gebaute Teuken aus dem Fraunhofer-Umfeld erreicht 47,7 Prozent im deutschen Wissenstest. Das gleich grosse Llama von Meta kommt auf 61,5. Für Deutsch trainiert zu sein, ersetzt kein gutes Training.
Auch die deutschsprachigen Spezialmodelle der Jahre 2023 und 2024, LeoLM, DiscoLM und SauerkrautLM, sind heute überholt. Grosse, gut trainierte Allrounder haben sie eingeholt.
Das heisst nicht, dass europäische Modelle abfallen. Mistral führt im selben Vergleich das Zusammenfassen an.
Drittens: Apertus ist stärker als sein Ruf
Apertus von ETH Zürich, EPFL und dem Supercomputing-Zentrum CSCS galt vielen als Transparenzprojekt ohne praktische Stärke. Der Vergleich widerlegt das: Beim Beantworten deutscher Fragen steht die grosse Variante auf Rang 3, vor GPT-4o.
Dazu kommt etwas, das sonst niemand bietet. Bei Apertus liegen nicht nur die Gewichte offen, sondern auch Trainingsdaten, Code und Zwischenstände. Für öffentliche Beschaffung ist das der entscheidende Unterschied.
Bei Schweizerdeutsch sollte man die Erwartungen trotzdem tief halten. Beim Verschriften gesprochener Mundart liegt etwa jedes vierte Wort daneben, auch bei eigens angepassten Modellen.
Was ein Modell kann und was es weiss
Ein Punkt wird selten erklärt, obwohl er fast alles erklärt: Ein Sprachmodell lernt Sprache und Wissen nicht in zwei getrennten Schritten, sondern gleichzeitig, aus denselben Daten und mit denselben Bausteinen. Trotzdem verhalten sich die beiden Fähigkeiten unterschiedlich.
Sprachliche Kompetenz, also Grammatik, Satzbau und Stil, entsteht früh und mit vergleichsweise wenig Material. Sprachliche Muster wiederholen sich und funktionieren zwischen verwandten Sprachen ähnlich. Faktenwissen dagegen lässt sich nicht aus Mustern ableiten, es muss gespeichert werden. Dafür hat ein Modell begrenzt Platz, grob gerechnet etwa zwei Bit pro Parameter.
Dieser Platz wird ungleich zwischen den Sprachen aufgeteilt. Weil der grösste Teil aller Trainingsdaten englisch ist, sitzt das meiste Wissen in der englischen Ecke des Modells. Untersuchungen zeigen, dass ein Modell dieselbe Tatsache auf Englisch korrekt wiedergibt und in einer anderen Sprache falsch, obwohl es diese Sprache flüssig spricht.
Für die Praxis heisst das: Ein Modell kann gutes Deutsch schreiben und auf Deutsch trotzdem weniger wissen. Bei kleinen Modellen verschärft sich das, weil der Platz insgesamt knapper ist. Die Sprache sitzt zuerst, das Wissen kommt zu kurz. Genau deshalb sind kleine Modelle brauchbar, wenn man ihnen den Inhalt mitliefert, etwa beim Zusammenfassen eines Dokuments, und unzuverlässig, wenn man sie nach Fakten fragt.
Warum der Vergleich mit ChatGPT hinkt
Wer ein lokales Modell mit ChatGPT vergleicht, vergleicht meist nicht Modell gegen Modell, sondern Modell ohne Internet gegen Modell mit Internet.
Die grossen Anbieter haben ihre Modelle mit einer Websuche verbunden. Das Modell entscheidet selbst, ob es aus dem eigenen Gedächtnis antwortet oder im Hintergrund sucht, und für den Anwender ist meist nicht sichtbar, was gerade passiert. Bei aktuellen oder spezifischen Fragen macht das einen grossen Unterschied und lässt das Modell kompetenter wirken, unabhängig davon, wie viel es selbst weiss.
Ein lokales Modell ohne Internetzugriff tritt in diesem Vergleich strukturell im Nachteil an. Fair wird es erst, wenn man entweder die Websuche beim Onlinedienst abschaltet oder dem lokalen Modell ebenfalls eine gibt. Letzteres geht, etwa mit Open WebUI und einer angebundenen Suchmaschine wie SearXNG.
Was auf welchem Gerät läuft
Hier hält sich ein Missverständnis hartnäckig: dass es für lokale KI eine Grafikkarte braucht. Das stimmt nicht. Ein Sprachmodell läuft auch nur mit Prozessor und normalem Arbeitsspeicher. Die interessantere Frage ist, wie schnell es antworten soll.
Es sind zwei getrennte Fragen, und sie werden ständig vermischt. Der Arbeitsspeicher ist das Regal, in dem das Modell liegt: Er entscheidet, welches Modell überhaupt geladen werden kann. Der Prozessor ist ein einzelner Koch, der die Rezepte nacheinander abarbeitet. Eine Grafikkarte sind Hunderte kleine Köche, die gleichzeitig rechnen, und der Grafikspeicher ist ihr Regal in Griffweite. Die Rechenleistung entscheidet also, wie schnell gearbeitet wird.
Daraus folgt: Mehr Arbeitsspeicher ersetzt keine Grafikkarte. Mit 64 GB lassen sich grössere Modelle laden, schnell werden sie dadurch nicht.
Wie viel Platz ein Modell braucht, lässt sich grob überschlagen: 7 bis 8 Milliarden Parameter belegen 4 bis 6 GB, 14 Milliarden 8 bis 10 GB, 32 Milliarden 18 bis 22 GB, 70 Milliarden 40 bis 50 GB. Dazu kommt Reserve für das Programm, den Gesprächsverlauf und die internen Berechnungen.
Für den privaten Einstieg genügt darum pragmatisch: moderner Prozessor, 32 GB Arbeitsspeicher, ein quantisiertes Modell mit 7 bis 8 Milliarden Parametern, dazu Ollama oder llama.cpp, und zuerst ohne separate Grafikkarte testen. Für gelegentliche Textfragen, Zusammenfassungen und einfache Dokumentenanalysen reicht das.
Interessant wird eine Grafikkarte, sobald man flüssig chatten, lange Dokumente verarbeiten oder mehrere Personen gleichzeitig bedienen will. Beim letzten Punkt hilft Arbeitsspeicher gar nicht: Ein Prozessor arbeitet die Anfragen nacheinander ab, ab der zweiten Person wartet jeder auf jeden.
Passt ein Modell nicht komplett in den Grafikspeicher, kann ein Teil im normalen Arbeitsspeicher bleiben. Dieses Offloading funktioniert, kostet aber Tempo, weil bei jedem Wort Daten über die langsamere Verbindung geholt werden. Oft ist ein kleineres Modell, das ganz hineinpasst, die bessere Wahl als ein grösseres, das nur halb hineinpasst.
Auf einem Smartphone laufen Modelle mit 2 bis 4 Milliarden Parametern, etwa Gemma 4 in der kleinsten Variante. Der Engpass ist dort nicht der Speicher, sondern die Wärme: Unter Dauerlast drosselt sich das Gerät selbst. Bei Apple-Chips teilen sich Prozessor und Grafikeinheit denselben schnellen Speicher, darum laufen dort Modelle, für die ein Windows-Notebook eine grosse Grafikkarte bräuchte.
Ein Detail erklärt, warum zwei gleich grosse Modelle unterschiedlich schnell sind: Qwen 3 mit 30 Milliarden Parametern läuft auf einem starken Notebook flüssig, weil bei jedem Wort nur 3 Milliarden davon mitrechnen. Metas Muse Glimmer ist gleich gross, rechnet aber immer mit allen. Das spart Rechenzeit, keinen Speicher, geladen werden muss trotzdem alles.
Vorsicht bei der Lizenz
Ein Punkt, der in Firmen regelmässig übersehen wird: Ein Modell, das sich frei herunterladen lässt, darf man nicht automatisch geschäftlich einsetzen.
Die einfache Regel: Steht beim Modell Apache 2.0 oder MIT, ist die geschäftliche Nutzung erlaubt, ohne Rückfrage. Das trifft auf die meisten Modelle zu.
Bei den übrigen lohnt der Blick in die Lizenzdatei. Codestral von Mistral etwa steht in den üblichen Katalogen und ist mit einem Befehl installiert, die Lizenz erlaubt aber keinen produktiven Einsatz. Beim deutschen Teuken gibt es zwei Varianten, von denen nur eine kommerziell nutzbar ist. Wer das übersieht, baut eine Lösung auf einer Grundlage, die er gar nicht verwenden darf.
Was du gegenüber ChatGPT aufgibst
An der Spitze ist der Abstand klein geworden. Im Deutschteil eines gängigen Wissenstests erreicht das beste Cloud-Modell 93,2 Prozent, das beste offene Modell 90,8. Nur braucht dieses offene Spitzenmodell einen Server, kein Notebook.
Weiter unten bleibt der Unterschied spürbar. Ein 8-Milliarden-Modell auf dem eigenen Gerät liegt bei anspruchsvollen Aufgaben klar hinter ChatGPT. Bei klar umrissenen Aufgaben wie Zusammenfassen fällt das kaum auf, weil dort der Inhalt mitgeliefert wird und das gespeicherte Wissen kaum ins Gewicht fällt.
Für die meisten entscheidet ohnehin nicht die letzte Genauigkeit, sondern wo die Daten liegen. Wer weder eigene Hardware noch einen amerikanischen Dienst will, hat einen dritten Weg: Infomaniak, Swisscom und Exoscale betreiben offene Modelle in Schweizer Rechenzentren, teils mit Apertus. Man zahlt nach Nutzung. Ob wirklich alle Verarbeitungsschritte in der Schweiz bleiben, also auch Websuche, externe Schnittstellen, Protokolle und Backups, steht im Vertrag mit dem Anbieter.
Die Übersicht bleibt in Bewegung
Der Markt bewegt sich schneller, als Artikel altern. Während wir recherchiert haben, hat Meta die Llama-Reihe abgelöst, Google die Lizenz von Gemma geöffnet und Cohere ein Modell nachträglich freigegeben.
Die Übersicht ist deshalb als laufend nachgeführte Seite angelegt, mit sichtbarem Stand und verlinkten Quellen. Recherche und Erstellung erfolgten mit Unterstützung von KI, alle Angaben wurden gegen die Originalquellen geprüft.